监控告警将设备状态变成运维线索
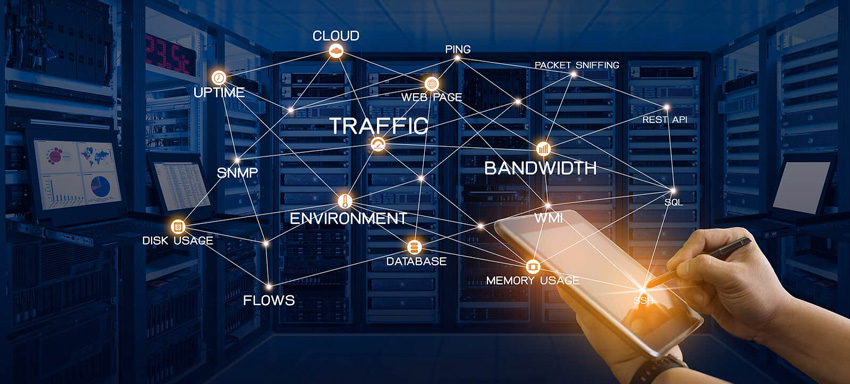
监控告警服务面向服务器、网络设备和链路等基础设施,采集运行指标与可用性状态,并通过规则、看板和通知帮助运维人员观察变化。
监控系统的价值不只在显示曲线,还在于指标是否对应实际问题、告警是否有责任人、处理结果是否能回看。规则需结合企业设备清单和运维流程配置。
Zabbix 是常见的企业级监控平台,适合对服务器、网络设备、链路状态和基础设施指标进行统一采集、阈值判断和告警通知。
Prometheus 是面向指标采集与时序数据处理的监控系统,常用于采集主机、服务、容器和应用指标,并结合规则引擎实现持续监控与告警。
Grafana 是常用的可视化平台,能够把服务器、网络、业务系统和应用指标整合为统一看板,帮助企业更直观地掌握运行状态。
告警阈值是触发告警的判断条件,例如 CPU 持续过高、磁盘空间不足、链路丢包率异常或服务不可访问,用于让运维团队更早介入处理问题。
告警数量多,并不代表异常容易处理
阈值过宽可能漏掉值得关注的变化,过窄则可能产生重复通知。没有级别、对象和处置方式的告警,也难以转化为有效行动。
梳理关键监控对象、告警条件和通知路径,可让人员先判断影响范围,再按优先级排查并记录处理情况。
从监控指标到误报治理,建设如何展开
服务包括服务器与网络设备监控、平台部署、规则与阈值配置、运行看板、异常通知和误报治理;接入前确认监控对象、采集权限和通知责任,后续按运行情况调整规则。
服务器与主机状态监控
针对 CPU、内存、磁盘、网络连接、进程状态和服务可用性建立持续监控,帮助企业及时发现服务器性能异常和资源耗尽风险。
交换机、路由器与网络链路监控
围绕交换机端口、路由器状态、互联网出口、专线链路和关键网络接口设置监控项,及时感知网络中断、抖动和带宽异常。
监控平台部署与规则配置
结合企业现有环境选用 Zabbix、Prometheus、Grafana 等工具,完成采集架构、监控模板、告警阈值和通知策略配置。
可视化看板与运行视图建设
将服务器、网络设备、链路质量和关键业务指标汇总为统一看板,让管理层和运维人员更直观地查看整体运行趋势。
异常通知与告警分级响应
按严重程度配置短信、邮件、企业微信或其他通知方式,避免同一问题反复打扰,并让关键告警能够及时触达处理人员。
监控优化与误报治理
按运行情况调整阈值和触发逻辑,减少重复告警,让监控支持运维判断。
让运行状态可见,让告警接上处理流程
把状态视图和告警等级对应起来,内部 IT 更容易区分设备波动、容量变化和需要进一步检查的问题。
如需将监控与边界策略、访问控制和安全日志检查衔接,可参阅 企业网络安全服务。
集中查看关键设备与链路状态变化。
指标和看板帮助团队了解资源与服务的当前情况。
按对象和影响程度整理通知,方便安排检查顺序。
根据实际运行调整阈值,减少重复且无行动价值的提醒。